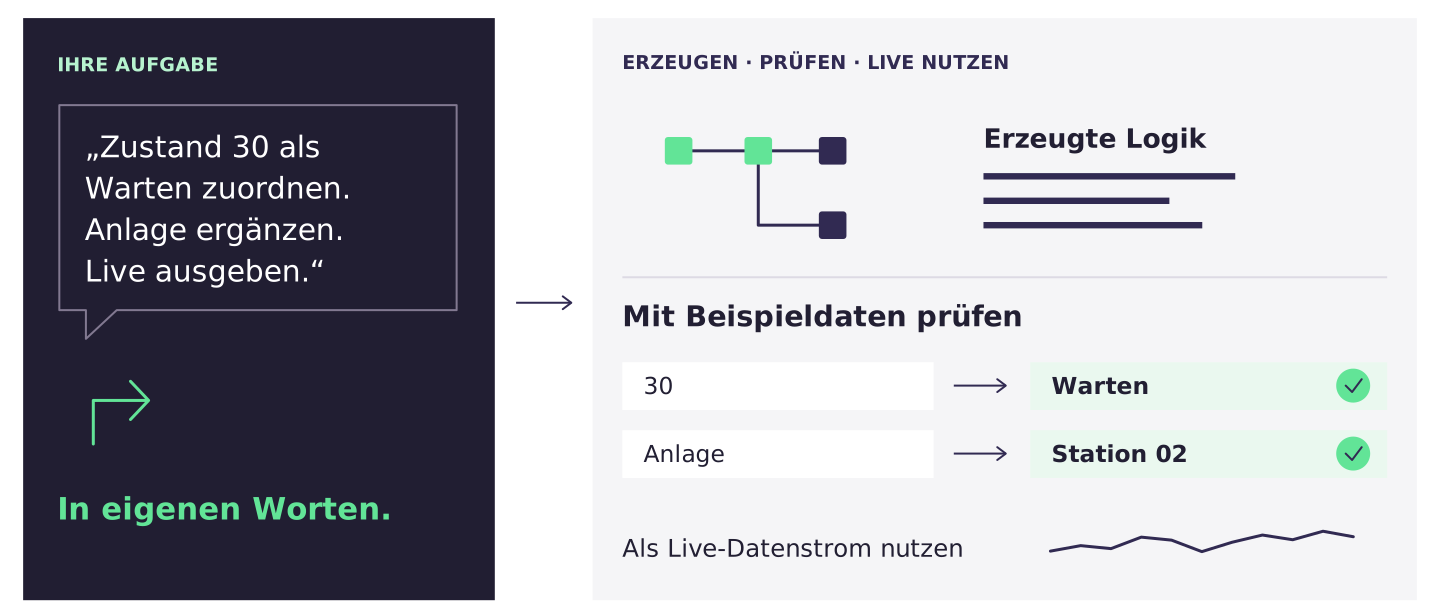
01Beschreiben
Die benötigte Live-Analyse fachlich formulieren
Nutzer beschreiben, welche Signale harmonisiert, überwacht oder ausgewertet werden sollen. Die Aufgabe bleibt damit an der Produktionsfrage ausgerichtet statt an verfügbaren Bausteinen.
IoT Data Hub · Echtzeitanalyse
KI-Pipelines definieren Datenanalysen auf Live-Datenströmen von Maschinendaten. Statt ausschließlich grafische Blöcke zu verbinden, lassen sich komplexere Überwachungen und Datenharmonisierungen per Sprache als erklärbarer Code erzeugen.
Diese Fähigkeit arbeitet auf derselben Konnektivität, Semantik, Historie und Governance wie alle Data-Hub-Werkzeuge.
KI-Pipelines schließen die Lücke zwischen verständlicher Fachanforderung und kontrolliert betriebener Echtzeitanalyse.
Mehrstufige Harmonisierung, Überwachung oder Mustererkennung wird in rein grafischen Modellen schnell unübersichtlich.
Code außerhalb der Datenplattform ist schwer gemeinsam zu testen, zu versionieren und für weitere Datenströme wiederzuverwenden.
Ohne geeignete Testdaten und eine sichtbare Ausführung bleiben Fehler oft bis zum Einsatz auf realen Maschinendaten verborgen.
Ergebnisse müssen wieder als Live-Daten verfügbar sein, damit weitere Pipelines, Datensenken oder Benachrichtigungen darauf reagieren können.
Den passenden Modellierungsweg wählen
Wiederverwendbare Standardlogik bleibt im grafischen Editor übersichtlich. KI-Pipelines erweitern den Workflow um erklärbaren Code für komplexere Live-Analysen und Harmonisierungsschritte.
30-Minuten-Demo anfragen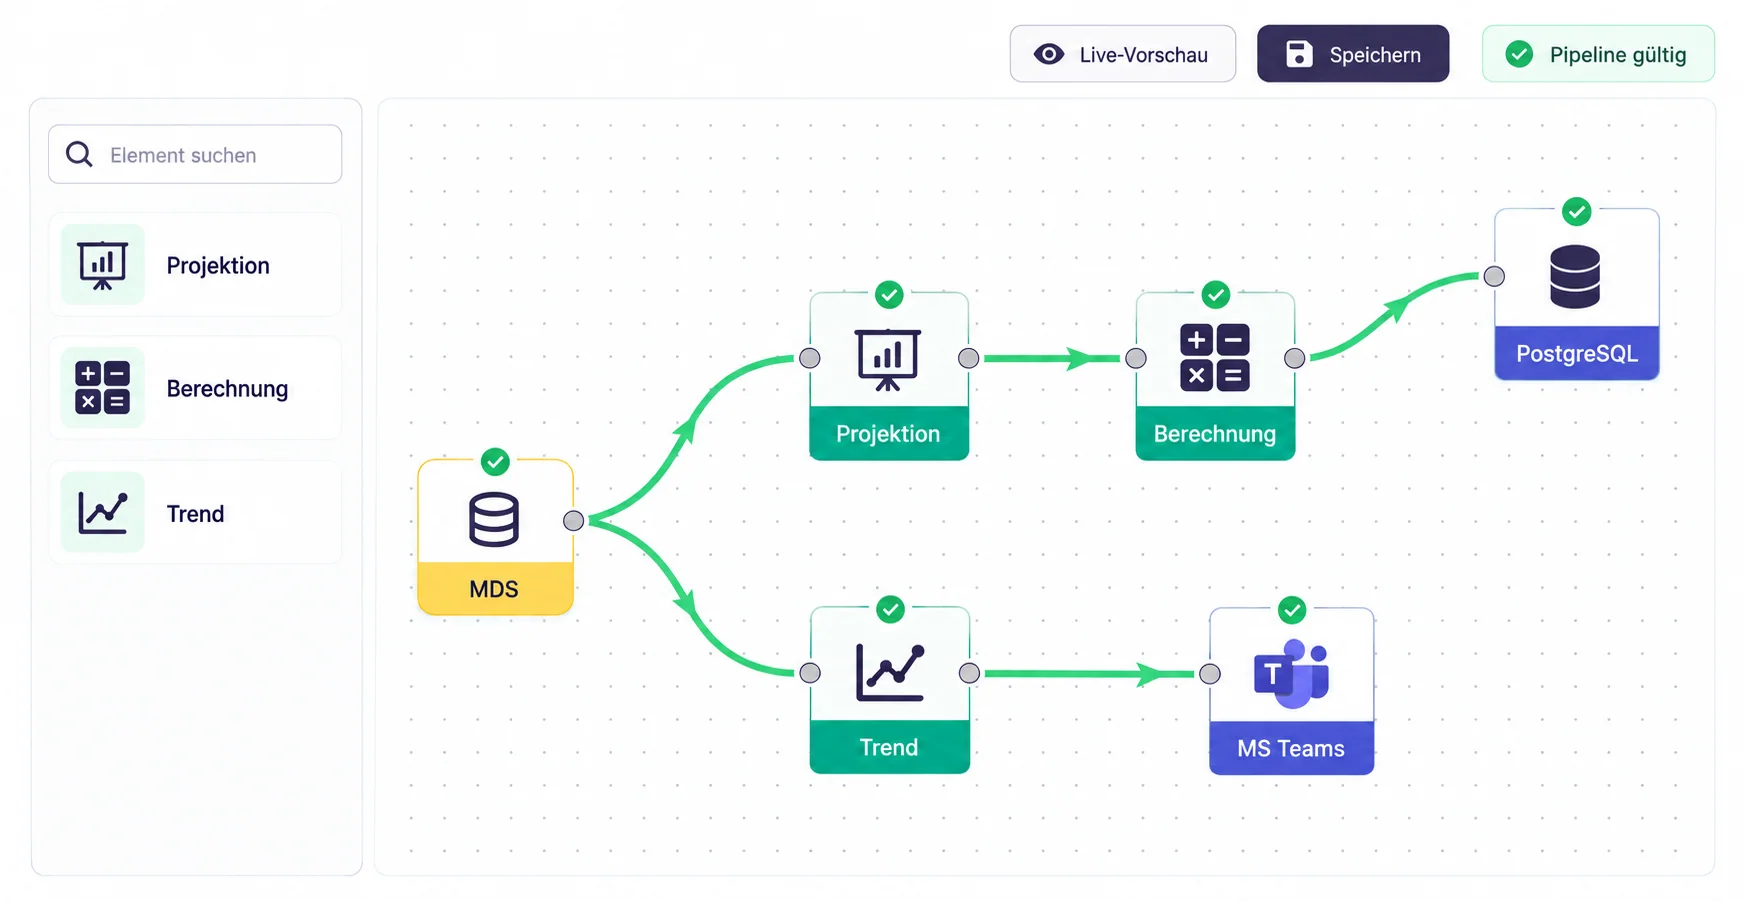
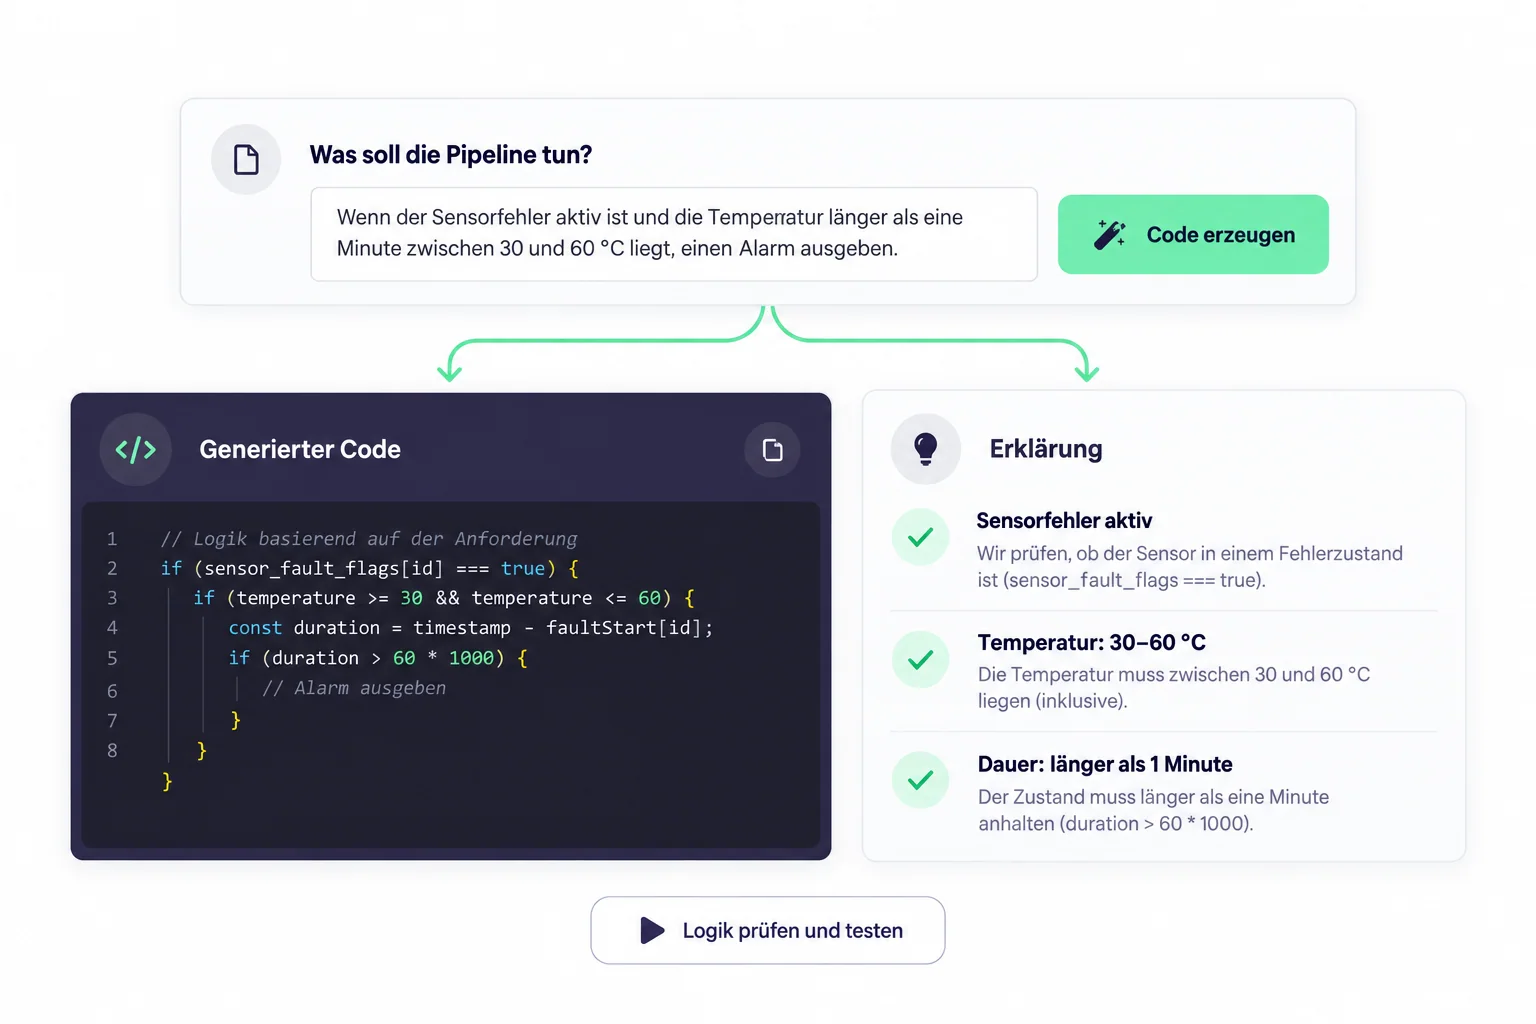
Nutzer beschreiben, welche Signale harmonisiert, überwacht oder ausgewertet werden sollen. Die Aufgabe bleibt damit an der Produktionsfrage ausgerichtet statt an verfügbaren Bausteinen.
Der erzeugte Code bleibt sichtbar, lässt sich erklären und kann vor der Ausführung geprüft oder angepasst werden. So entsteht keine verborgene Analyse-Blackbox.
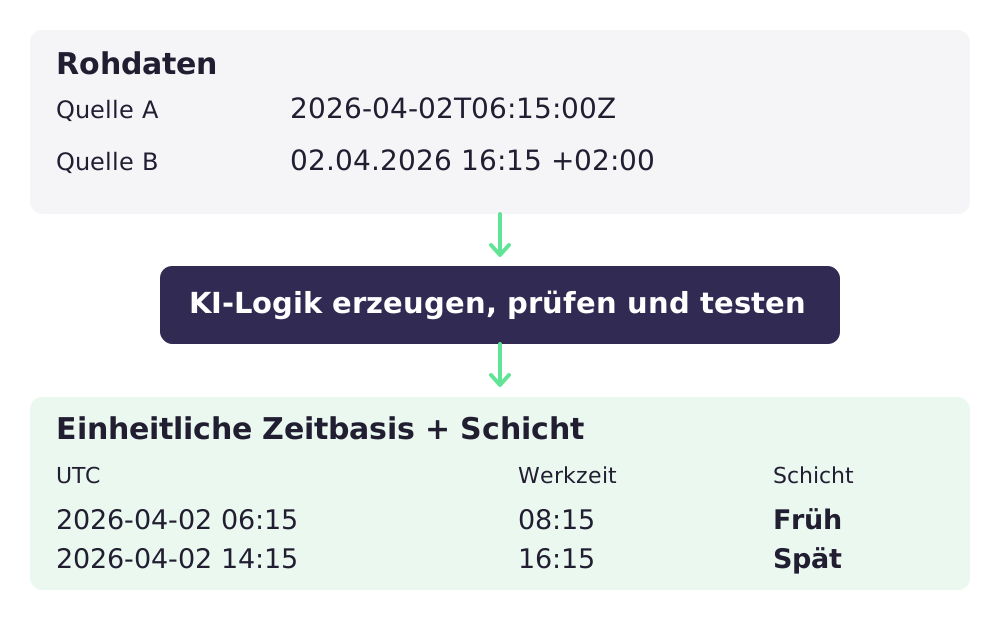
Testdaten helfen, Verhalten und Ausgabe vor dem produktiven Einsatz zu prüfen. Anpassungen bleiben Teil desselben nachvollziehbaren Workflows.
Die ausgeführte Analyse liefert kontinuierlich neue Datenströme. Diese können gespeichert, visualisiert oder von weiteren Pipelines und Aktionen genutzt werden.
Von der fachlichen Definition bis zur Rückführung der Ergebnisse in laufende Datenströme.
Komplexe Live-Überwachungen und Datenharmonisierungen als fachliche Anforderung beschreiben.
Generierten Code sichtbar halten, erklären, prüfen und vor der Ausführung anpassen.
Analytische Logik kontinuierlich auf hochfrequenten Maschinendaten ausführen.
Resultate als neue Live-Datenströme für Visualisierung, Speicherung und Aktionen bereitstellen.
Einordnung und Betrieb
Nein. Grafische Pipelines bleiben der direkte Weg für wiederverwendbare Standardbausteine. KI-Pipelines ergänzen sie dort, wo eine Analyse oder Harmonisierung als grafisches Modell zu starr oder zu komplex wäre.
Ja. Der Code bleibt sichtbar, kann erklärt und angepasst werden und lässt sich mit Testdaten prüfen, bevor er auf produktiven Live-Datenströmen ausgeführt wird.
Die eigentlichen Live-Daten müssen nicht an das Sprachmodell übertragen werden. Das Modell unterstützt die Codeerzeugung; Datenzugriff und Ausführung erfolgen kontrolliert innerhalb der Plattformarchitektur.
KI-Notebooks eignen sich für explorative Fragen auf gespeicherten Daten. KI-Pipelines sind für kontinuierliche Harmonisierung, Überwachung und Analyse laufender Datenströme gedacht.
30-Minuten-Produktdemo
Wir zeigen, wie aus einer fachlichen Beschreibung nachvollziehbarer Code, ein geprüfter Test und ein produktiver Live-Datenstrom entstehen.
Produktdemo mit konkretem Live-Datenfall